May 4, 2026 IEEE International Conference on Acoustics, Speech, and Signal Processing (ICASSP) Rethinking Music Captioning with Music Metadata LLMs Irmak Bukey, Zhepei Wang, Chris Donahue, Nicholas J. Bryan
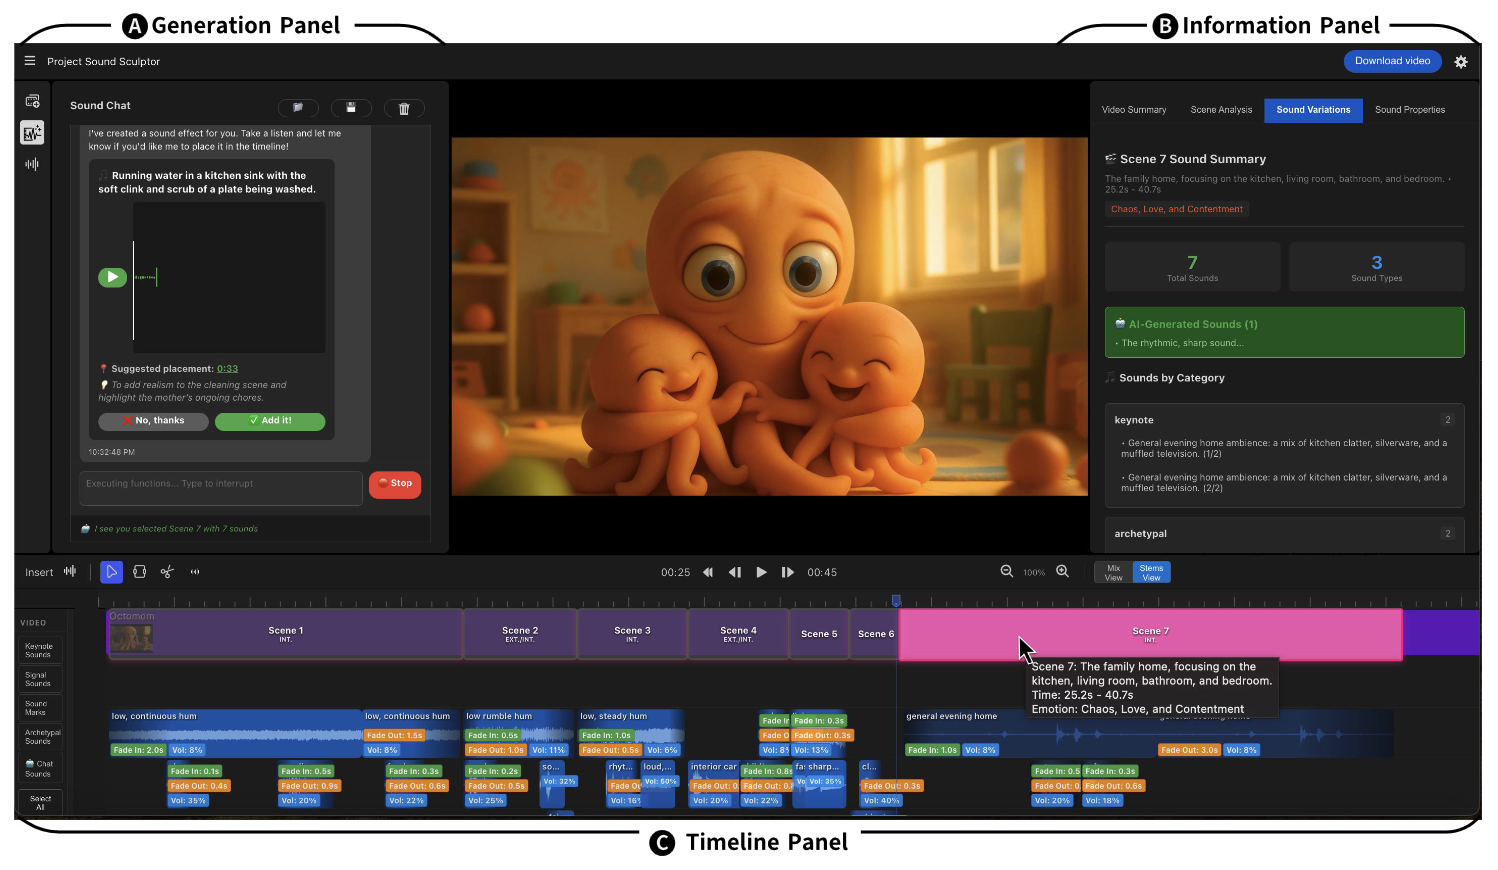
April 13, 2026 ACM Conference on Human Factors in Computing Systems (CHI 2026) SoundStager: Interactive Design of Story-Driven GenAI Soundscapes for Video Suhyeon Yoo, Adolfo Hernandez Santisteban, Prem Seetharaman, Justin Salamon, Oriol Nieto, Anh Truong
April 13, 2026 CHI 2026 MoSound: An Interactive Tool for Generative Sound Design in Motion Graphics Jialin Huang, Prem Seetharaman, Tim Langlois, Li-Yi Wei, Rubaiat Habib, Yotam Gingold Best paper honorable mention
April 13, 2026 CHI Conference on Human Factors in Computing Systems (CHI 2026) VidTune: Creating Video Soundtracks with Generative Music and Video-Based Thumbnails Mina Huh, Ailie Fraser, Dingzeyu Li, Mira Dontcheva, Bryan Wang
November 5, 2025 Transactions on Machine Learning Research DRAGON: Distributional Rewards Optimize Diffusion Generative Models Yatong Bai, Jonah Casebeer, Somayeh Sojoudi, Nicholas J. Bryan
October 13, 2025 IEEE Workshop on Applications of Signal Processing to Audio and Acoustics (WASPAA 2025) Learning to Upsample and Upmix Audio in the Latent Domain Dimitrios Bralios, Paris Smaragdis, Jonah Casebeer
October 12, 2025 IEEE Workshop on Applications of Signal Processing to Audio and Acoustics (WASPAA) SILA: Signal-to-Language Augmentation for Enhanced Control in Text-to-Audio Generation Sonal Kumar, Prem Seetharaman, Justin Salamon, Oriol Nieto
August 31, 2025 IEEE International Workshop on Machine Learning for Signal Processing (MLSP 2025) Re-Bottleneck: Latent Re-Structuring for Neural Audio Autoencoders Dimitrios Bralios, Jonah Casebeer, Paris Smaragdis Best Paper
July 4, 2025 ACM Designing Interactive Systems Conference (DIS 2025) “It’s more of a vibe I’m going for”: Designing Text-to-Music Generation Interfaces for Video Creators Noor Hammad, Ailie Fraser, Erik Harpstead, Jessica Hammer, Mira Dontcheva
May 8, 2025 International Conference on Machine Learning (ICML) FLAM: Frame-Wise Language-Audio Modeling Yusong Wu, Christos Tsirigotis, Ke Chen, Cheng-Zhi Anna Huang, Aaron Courville, Oriol Nieto, Prem Seetharaman, Justin Salamon